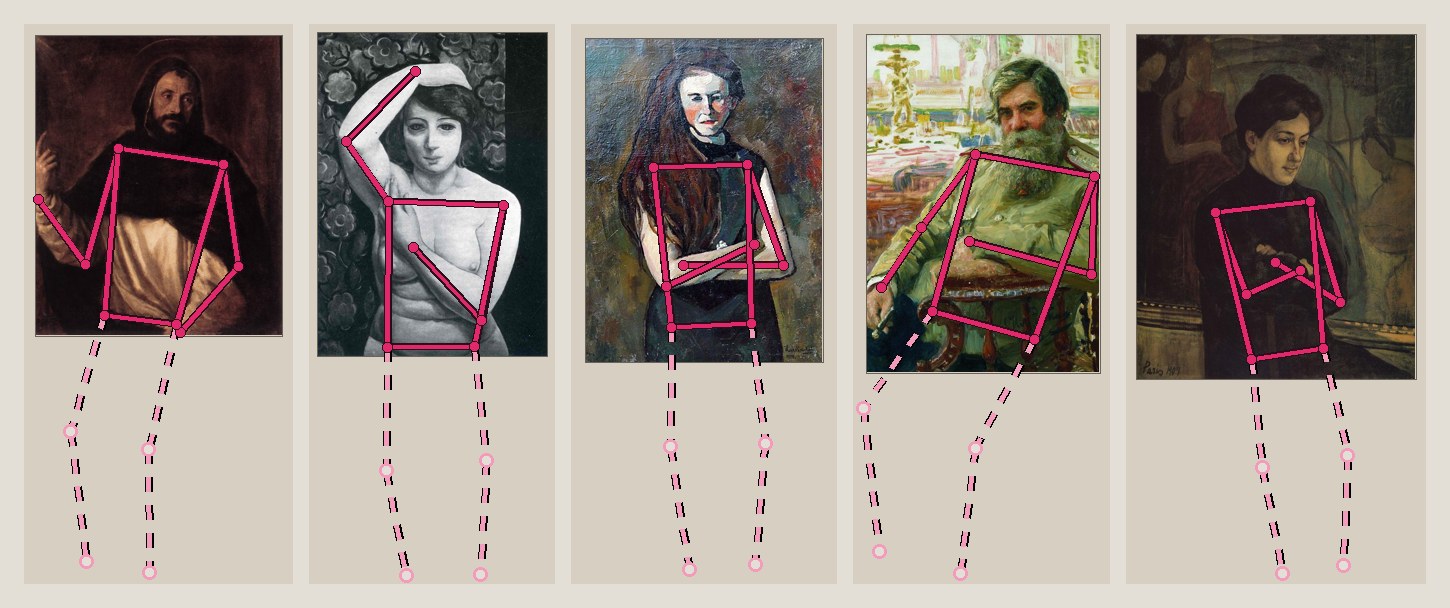
El hueco
Este proceso explica cómo he entrenado una red neuronal pequeña, de 300 KB, que solo propone dónde estarían las piernas de las figuras en obras de arte que no las tienen. Como se ve en el vídeo, esta red neuronal es para una exploración visual. Genero una Partitura de posturas obtenidas de cuadros tras ver un vídeo de alguien bailando (o delante de una cámara).
En detalle, la Partitura compara el cuerpo de una persona que baila con 2.228 figuras, sacadas de 1.630 obras de arte del conjunto PoPArt (Poses of People in Art, posturas de personas en el arte). Para compararlos reduce cada cuerpo a 12 articulaciones: hombros, codos, muñecas, caderas, rodillas y tobillos. De ahí saca 80 números que describen su geometría (dónde está cada punto respecto a las caderas, hacia dónde apunta cada hueso, cuánto se dobla cada codo y cada rodilla), y busca en un índice las figuras cuyos 80 números se parecen más. Eso lo conté en Rosetta - Postmortem de una piedra que no estaba.
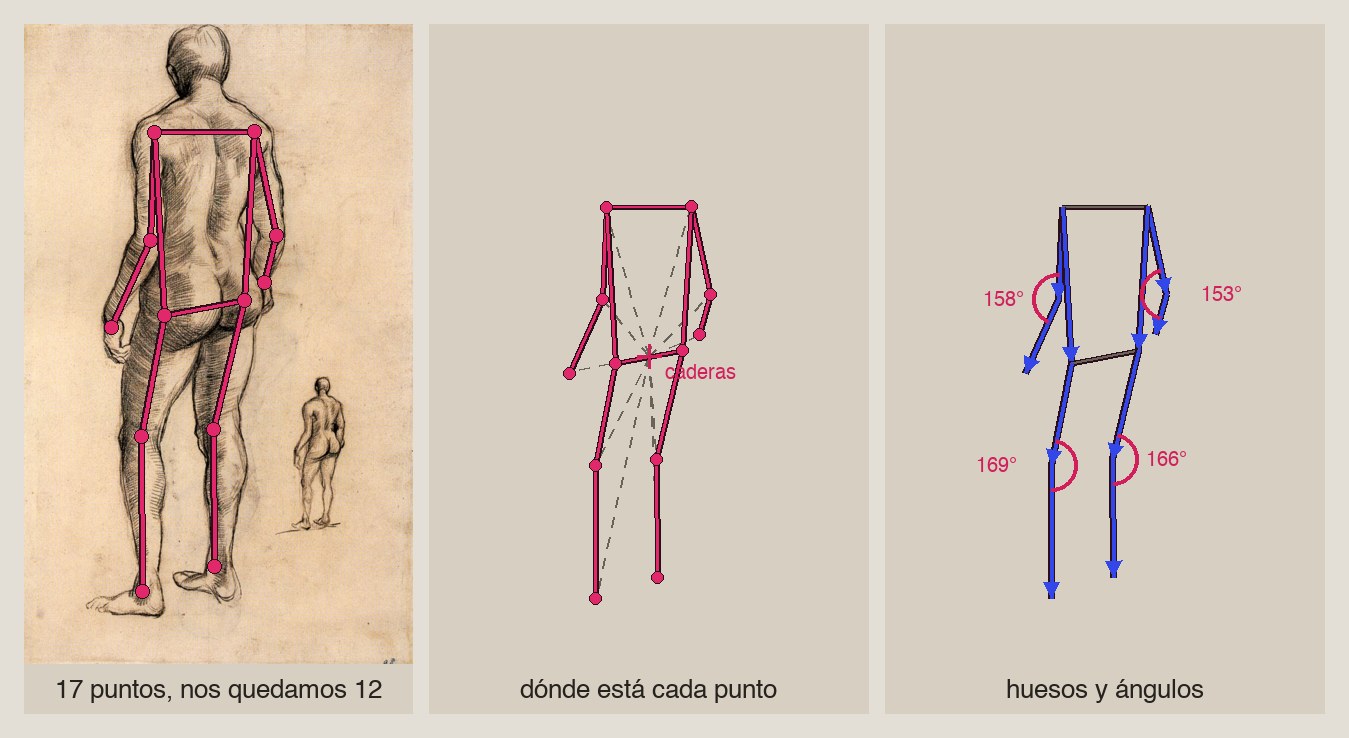
Un dibujo de Van Gogh reducido a geometría. De los 17 puntos que da la anotación se descartan los cinco de la cabeza. Con los 12 que quedan se mide dónde está cada punto respecto al centro de las caderas, hacia dónde apunta cada hueso y cuánto se doblan codos y rodillas.
El problema es que la pintura no enseña cuerpos enteros. Hay retratos de medio cuerpo, santos cortados por el marco, madonas detrás de un parapeto, figuras sentadas con las piernas tapadas por un manto. De las 2.228 figuras, 648 tienen al menos una rodilla o un tobillo sin anotar. Para la geometría esas piernas no existen, y la figura se compara mal. Tampoco puede inventarlas, porque solo sabe medir lo que hay.
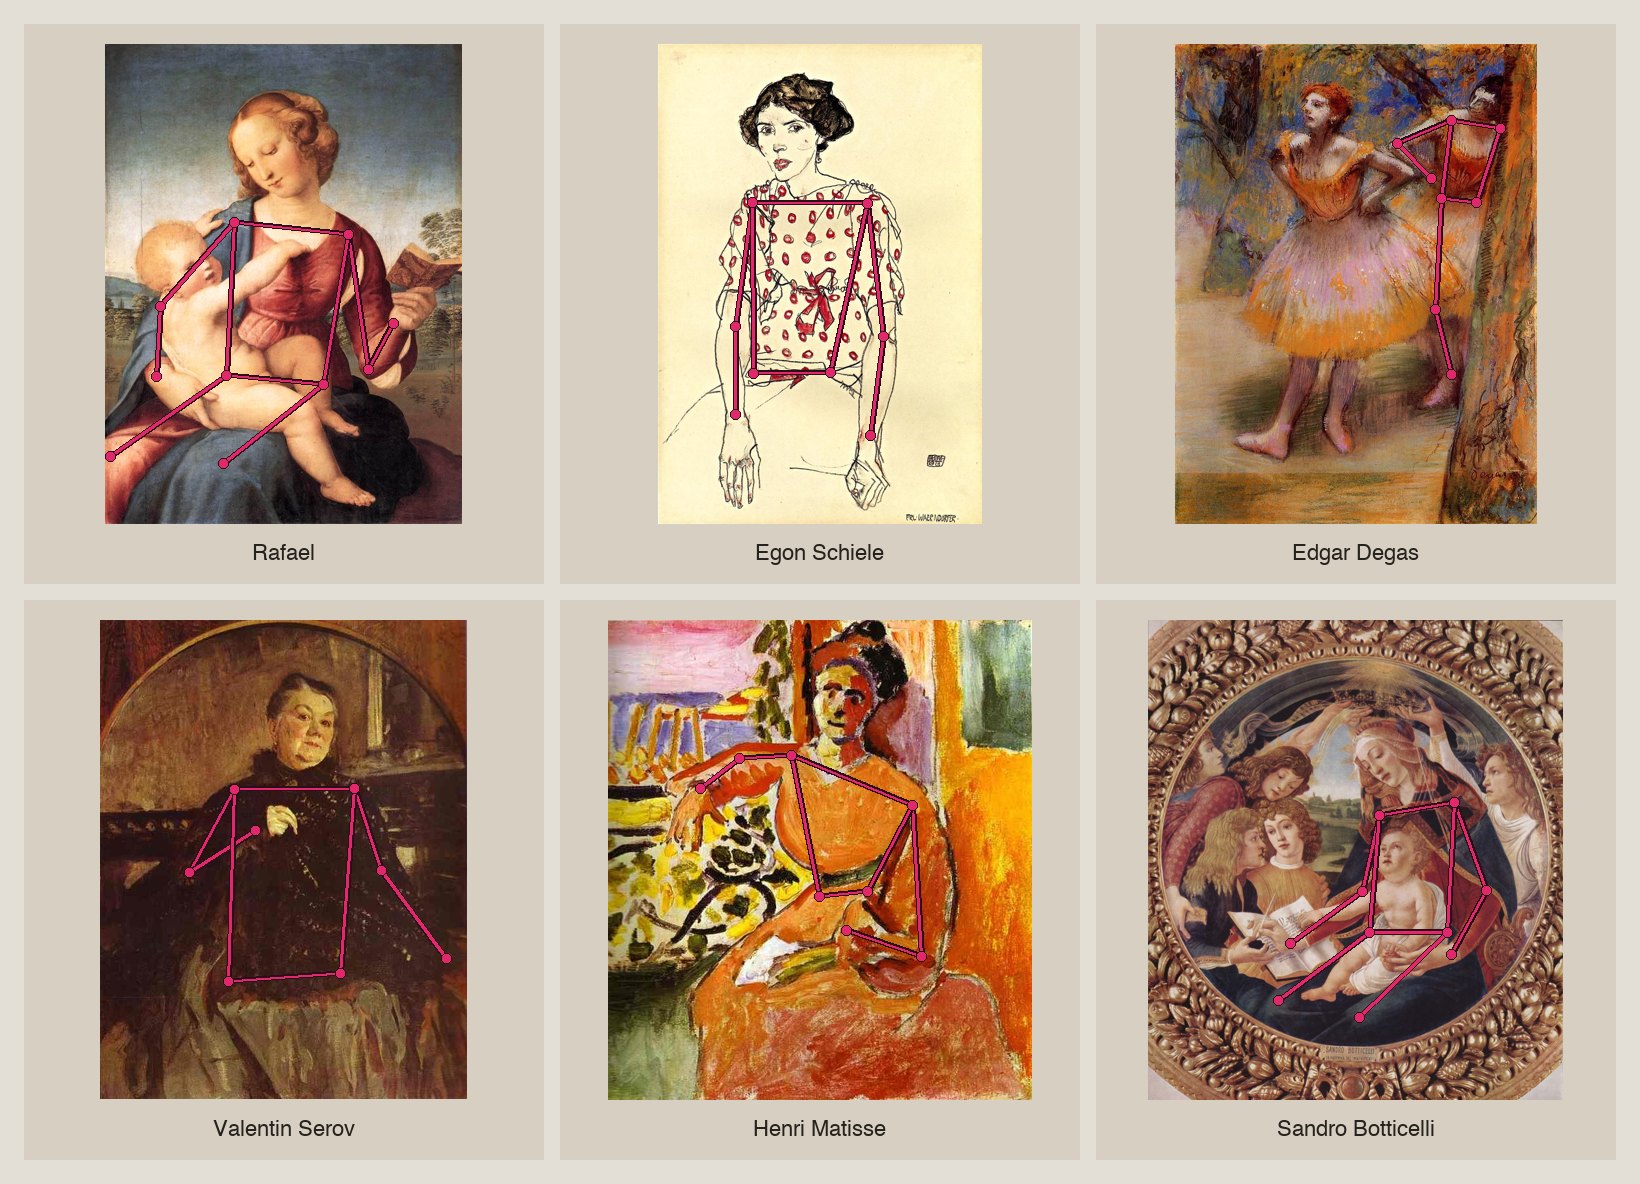
Seis de las 648. La madona de Rafael, la señorita Waerndorfer de Schiele, la bailarina de Degas que se esconde detrás de un árbol, el retrato de Serov, la mujer sentada de Matisse y la Virgen del Magnificat de Botticelli. En blanco, lo que está anotado. A todas les faltan las piernas, del todo o en parte.
Alguien que ha visto muchos cuerpos sí puede decir, mirando un torso y unos brazos, dónde estarían más o menos las piernas. Un modelo pequeño puede aprender eso, porque la respuesta no está en el cuadro: está en los miles de cuerpos completos que ha visto antes.
El modelo es una red neuronal, una función con muchos números ajustables (los pesos) que convierte una entrada en una salida. Al principio los pesos están al azar y la salida es basura. Entrenar es enseñarle ejemplos de los que conoces la respuesta, medir cuánto se equivoca y mover un poco los pesos para que se equivoque menos, miles de veces, hasta que también acierta con ejemplos que no ha visto. Aquí la entrada son las coordenadas del torso y los brazos, y la salida, las de las piernas.
La regla antes de entrenar
Para rellenar piernas no hace falta ninguna red. Basta con buscar, entre los cuerpos que sí tienen piernas, el que más se parece de torso y brazos, y copiarle las suyas. Es sencillo y funciona bastante bien. Antes de entrenar dejé escrito que la red solo se usaría si rellenaba mejor que ese vecino. Si empataba, me quedaba con el vecino, que no hay que entrenar ni mantener.
En estos momentos es mejor dejar las cosas por escrito antes, porque la adulación salta rápido y el autoconvencimiento está a la vuelta de la esquina.
Los datos
Para entrenar hacen falta cuerpos completos, porque la respuesta correcta son sus piernas. Junté tres fuentes y me quedé solo con los cuerpos en los que las 12 articulaciones se ven con claridad:
| Fuente | Qué hay | Cuerpos para entrenar |
|---|---|---|
| COCO (Common Objects in Context, objetos comunes en contexto) | Fotos de calle: gente sentada, corriendo, en bici | 808 |
| DeepFashion | Fotos de catálogo de moda, de pie y de frente | 1.283 |
| PoPArt | Figuras de cuadros que sí tienen piernas | 1.140 |
Aparté otros 396 para ir viendo cómo aprendía, y para la prueba final 295 figuras de cuadros que la red no vio nunca. Las obras se repartieron enteras, de forma que una misma pintura nunca está a la vez en el entrenamiento y en la prueba.
Cada cuerpo entra normalizado: centrado en las caderas y a escala del torso, de modo que la distancia de las caderas a los hombros vale uno. Así un cuadro de 300 píxeles y una foto de 3.000 hablan en las mismas unidades, y por eso los errores se pueden medir en torsos.
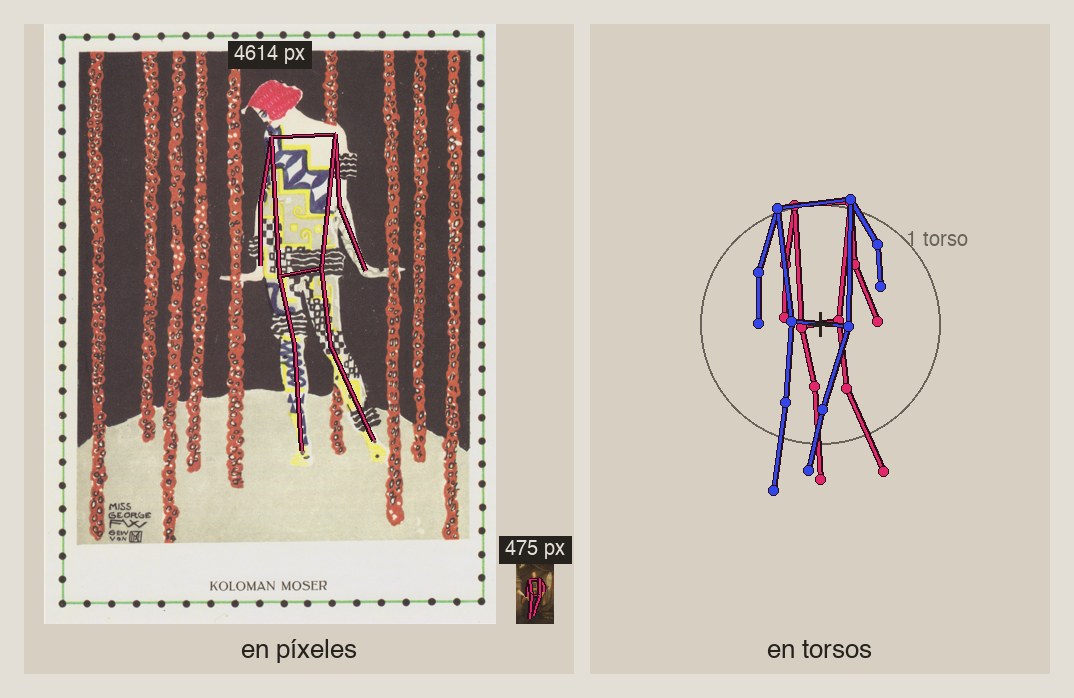
Una bailarina de Koloman Moser en una imagen de 4.614 píxeles de alto y un retrato de Miklós Barabás de 475. A la izquierda, tal como llegan. A la derecha, normalizados: las dos caderas en el mismo origen y el torso midiendo uno. Ya se pueden comparar.
Tapar para aprender
La red aprende a base de que le tape las piernas a cuerpos que sí las tienen, y le pregunte dónde estaban. En cada pasada por los datos el tapado se sortea de nuevo, imitando cómo faltan las piernas en la pintura: la mitad de las veces sin piernas, un 30 % solo con las rodillas, y un 20 % con una pierna entera tapada.
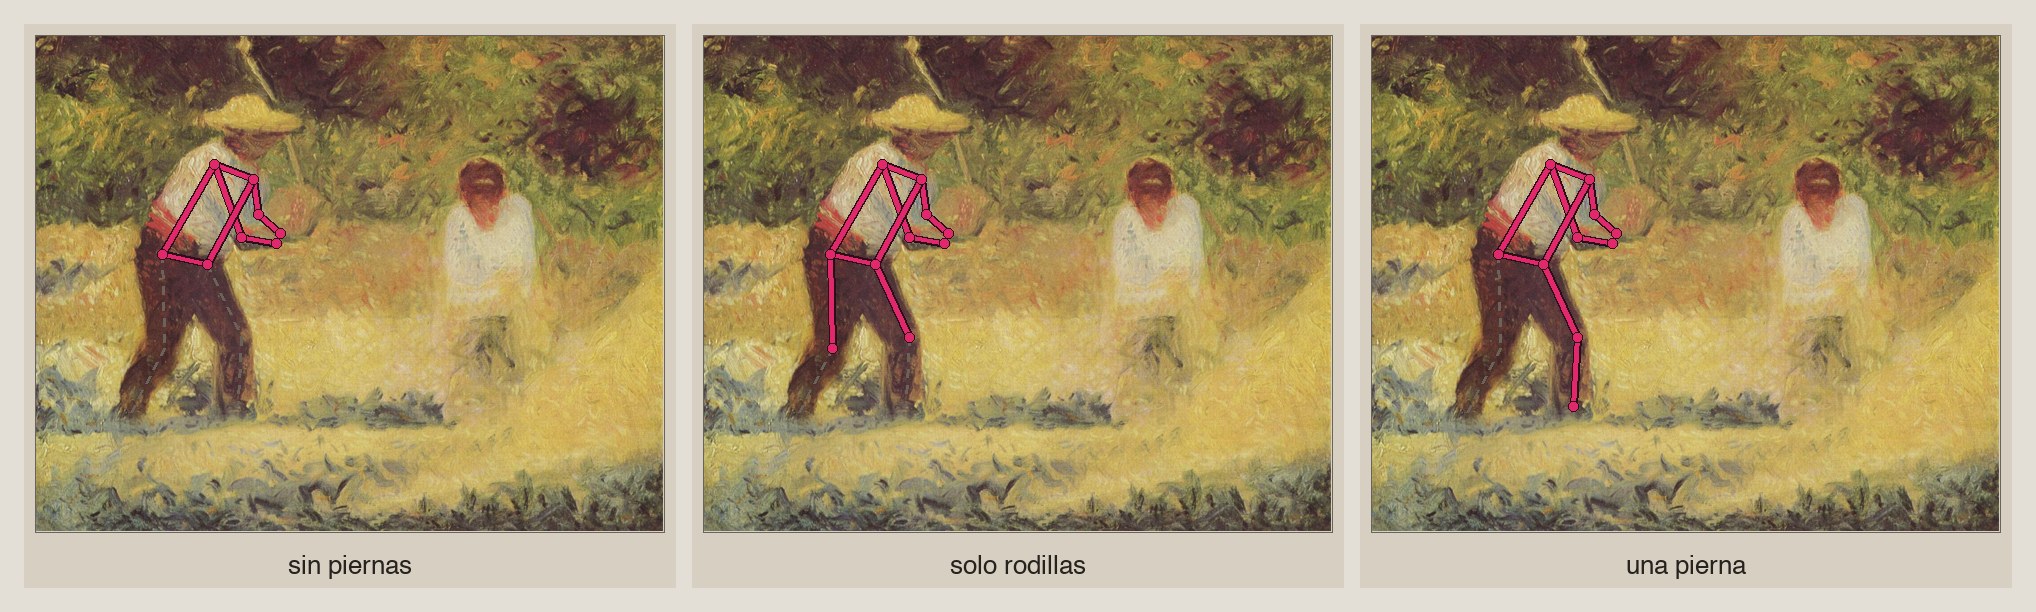
El picapedrero de Seurat (1884), uno de los cuerpos de prueba, con los tres modos de tapado. En gris, a trazos, lo que la red no ve.
Además le doy la vuelta en espejo a la mitad de los cuerpos y les aplico un pequeño giro y una pequeña deformación, para que no se aprenda de memoria las posturas.
La red
Es un perceptrón de los de toda la vida, escrito en numpy, sin PyTorch ni nada que instalar aparte. Entran 36 números, que son las 12 articulaciones del cuerpo con su x, su y y su confianza. Las rodillas y los tobillos también entran, pero a cero, porque son justo lo que está tapado. Esos 36 números pasan por dos capas de 256 neuronas y salen 12, que ya solo hablan de las cuatro articulaciones que faltan: para cada rodilla y cada tobillo, su x, su y y un número que dice cuánto duda la red. En total son 78.348 pesos, 314 KB en disco.
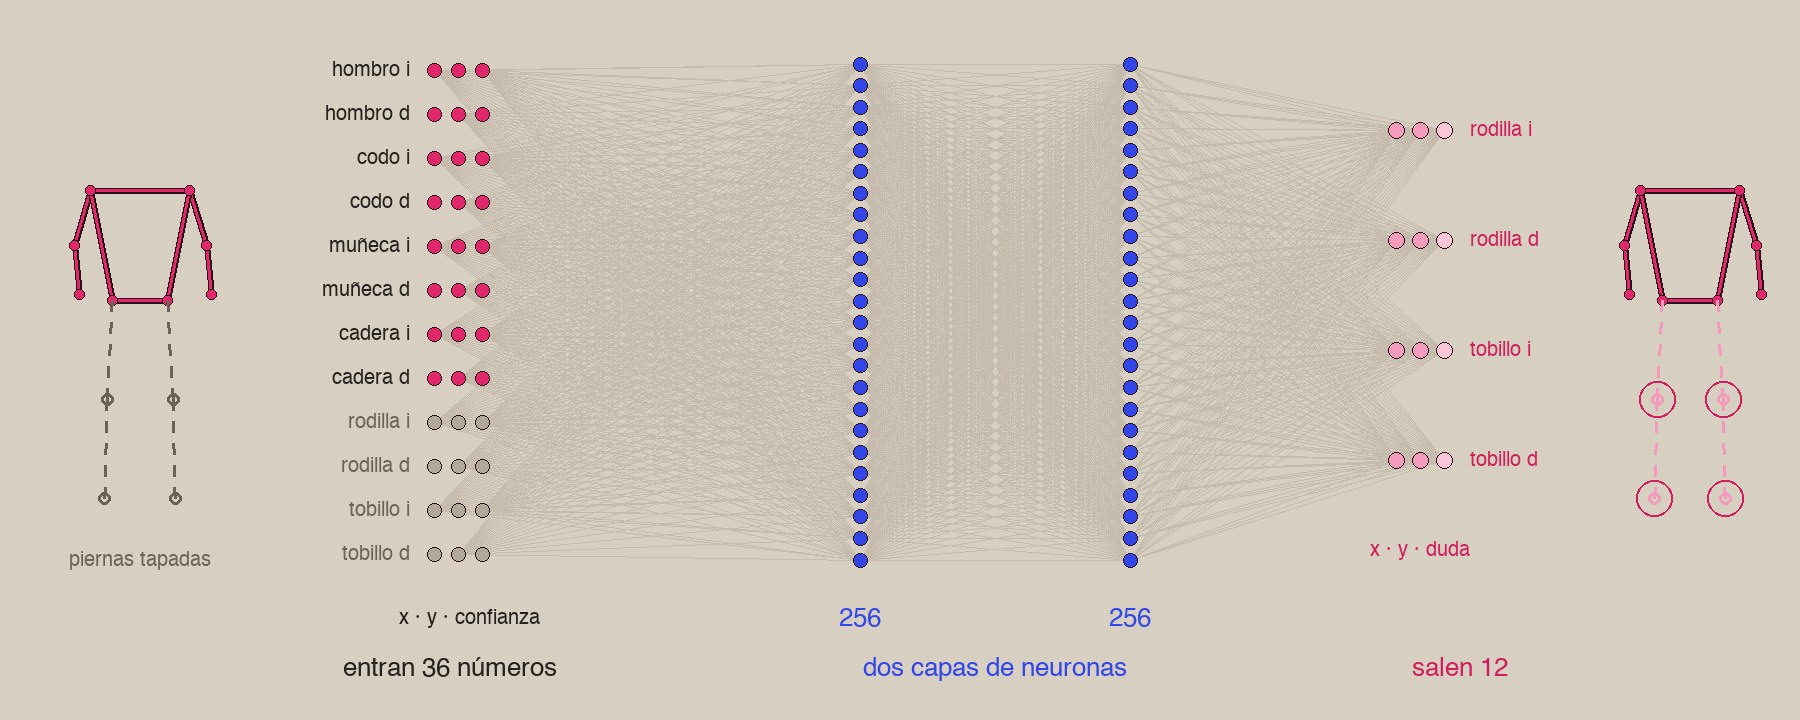
Lo que entra y lo que sale. Las rodillas y los tobillos entran apagados y salen con una propuesta y un círculo de duda.
Al entrenar, cada error se convierte en un castigo, y la red ajusta sus pesos para que el castigo baje. Lo normal es castigar solo la distancia entre la pierna propuesta y la real. Aquí la red, además, dibuja un círculo alrededor de cada propuesta, que viene a decir «la rodilla está por aquí dentro». El castigo funciona como una apuesta. Si dibuja un círculo pequeño y la rodilla real cae lejos, paga mucho. Si dibuja un círculo enorme, paga siempre un poco, acierte o no. Lo que más le conviene es dibujar el círculo del tamaño de lo que de verdad sabe, y así aprende a la vez dónde van las piernas y cuándo no lo sabe. Un tobillo bajo un manto largo sale con un círculo grande, y una rodilla en una figura de pie, con uno pequeño. (La cuenta sale de la distribución de Laplace, y por eso se llama verosimilitud de Laplace.)
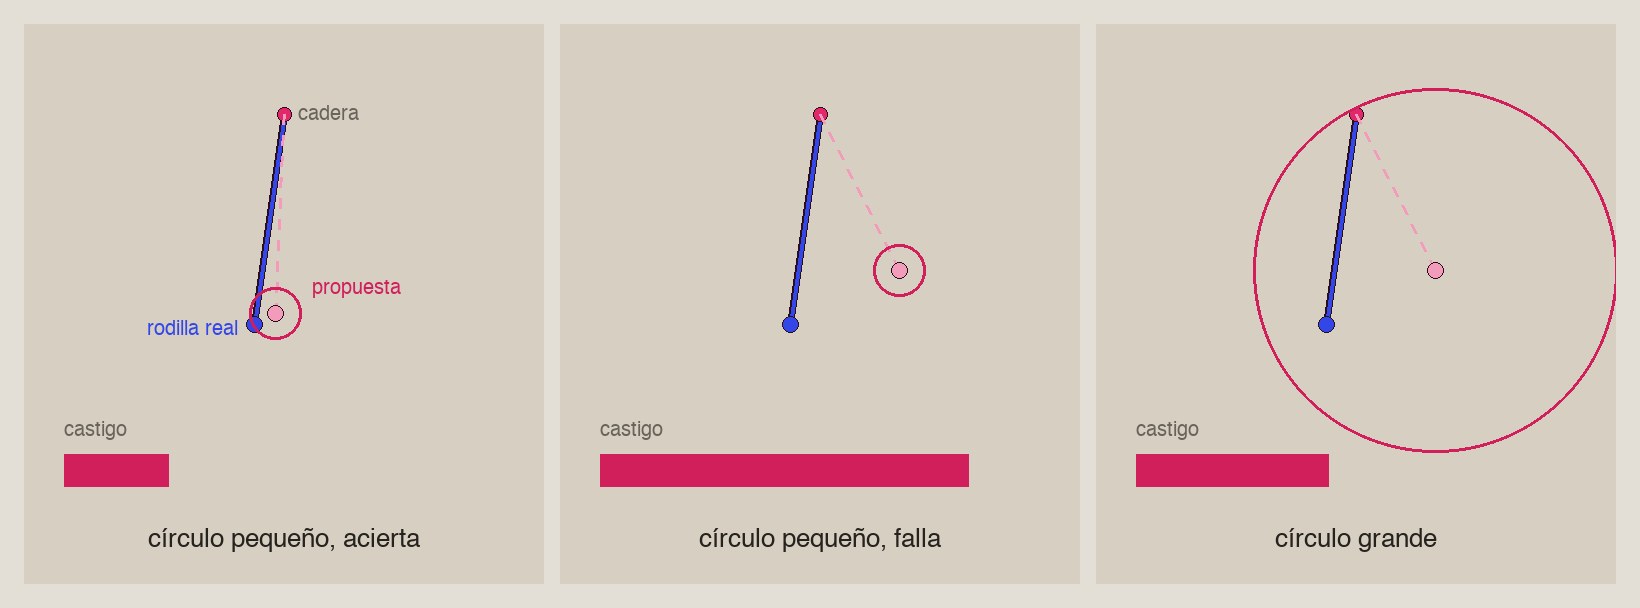
Tres apuestas sobre la misma rodilla. Con el círculo pequeño, acertar sale barato y fallar sale muy caro. Con el círculo grande, el castigo es medio pase lo que pase.
Medirla contra lo que no es una red
La comparé con tres maneras de rellenar sin red: poner siempre unas piernas medias, copiar las del cuerpo más parecido y hacer la media de los cinco más parecidos.
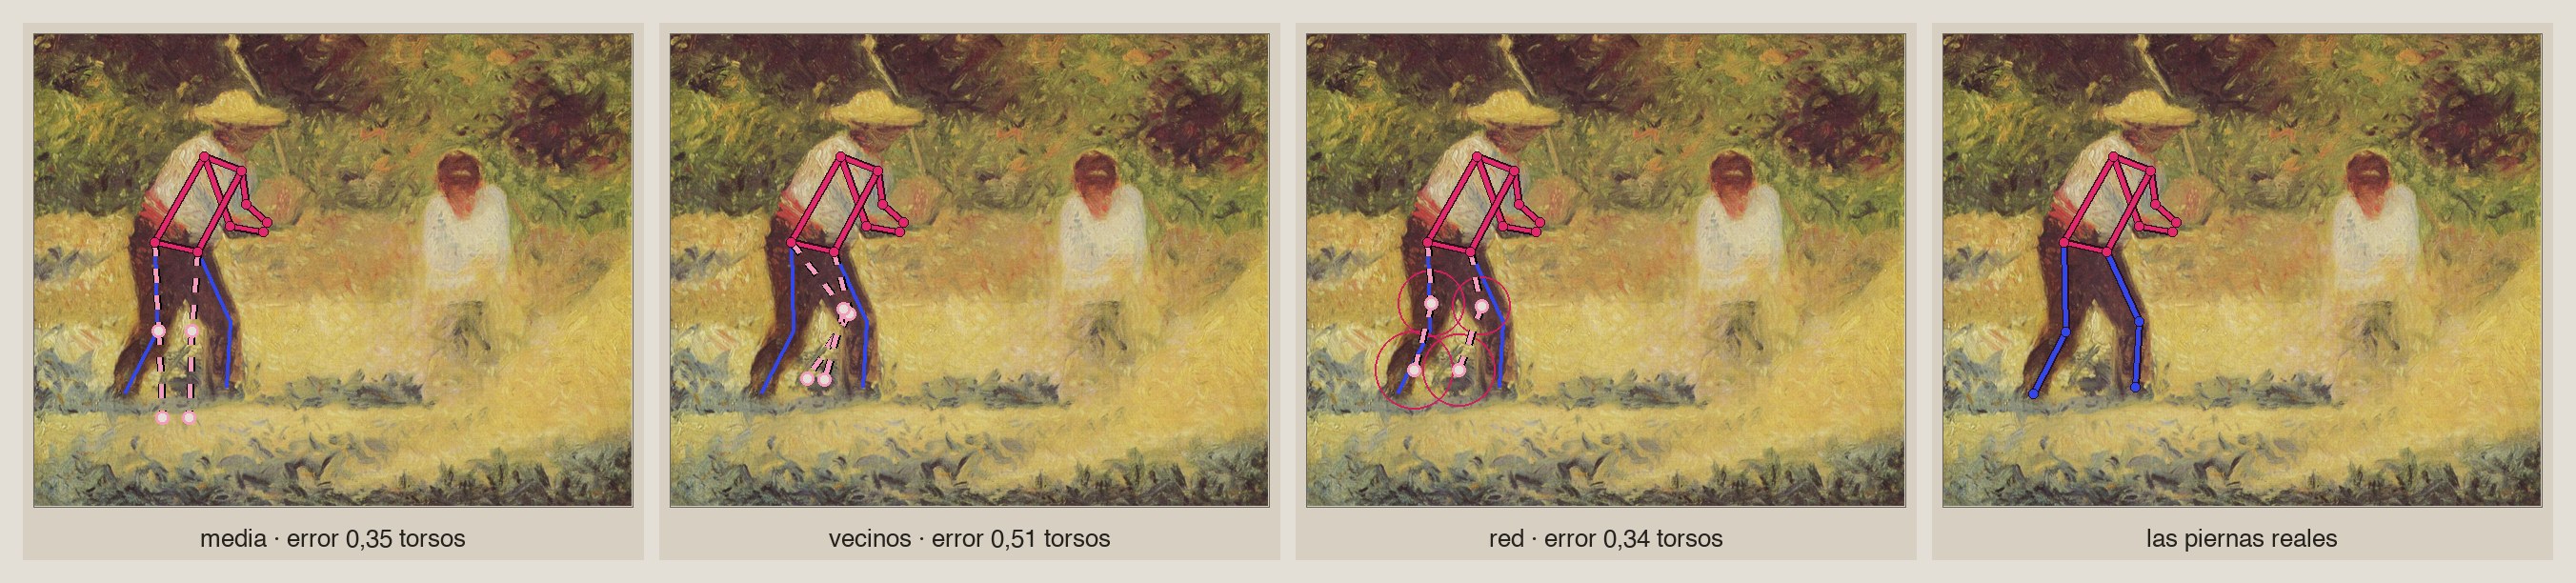
El picapedrero con las piernas tapadas y tres propuestas. En azul, las piernas reales; a trazos, las propuestas; los círculos de la red son su duda. En este cuadro la media casi empata con la red y el vecino se va lejos. En un solo cuadro cualquiera puede ganar, y por eso la comparación se hace sobre cientos.
Sobre las 295 figuras de prueba, la red falla de media 0,60 torsos, los cinco vecinos 0,63 y las piernas medias 0,70. La diferencia es pequeña, y lo que importa es lo que pasa después: con las piernas de la red, la Partitura elige el mismo cuadro que elegiría con las piernas reales un 31 % de las veces, con las del vecino un 23 % y con las piernas vacías casi nunca (0,7 %). La regla se cumplía. Después lo miré yo, en dos revisiones a ciegas en las que elegía entre pares de cuadros sin saber qué método había propuesto cada uno. Ganó la red por poco (7 a 5). La red coloca mejor las piernas; no es una diferencia exagerada, pero funciona.
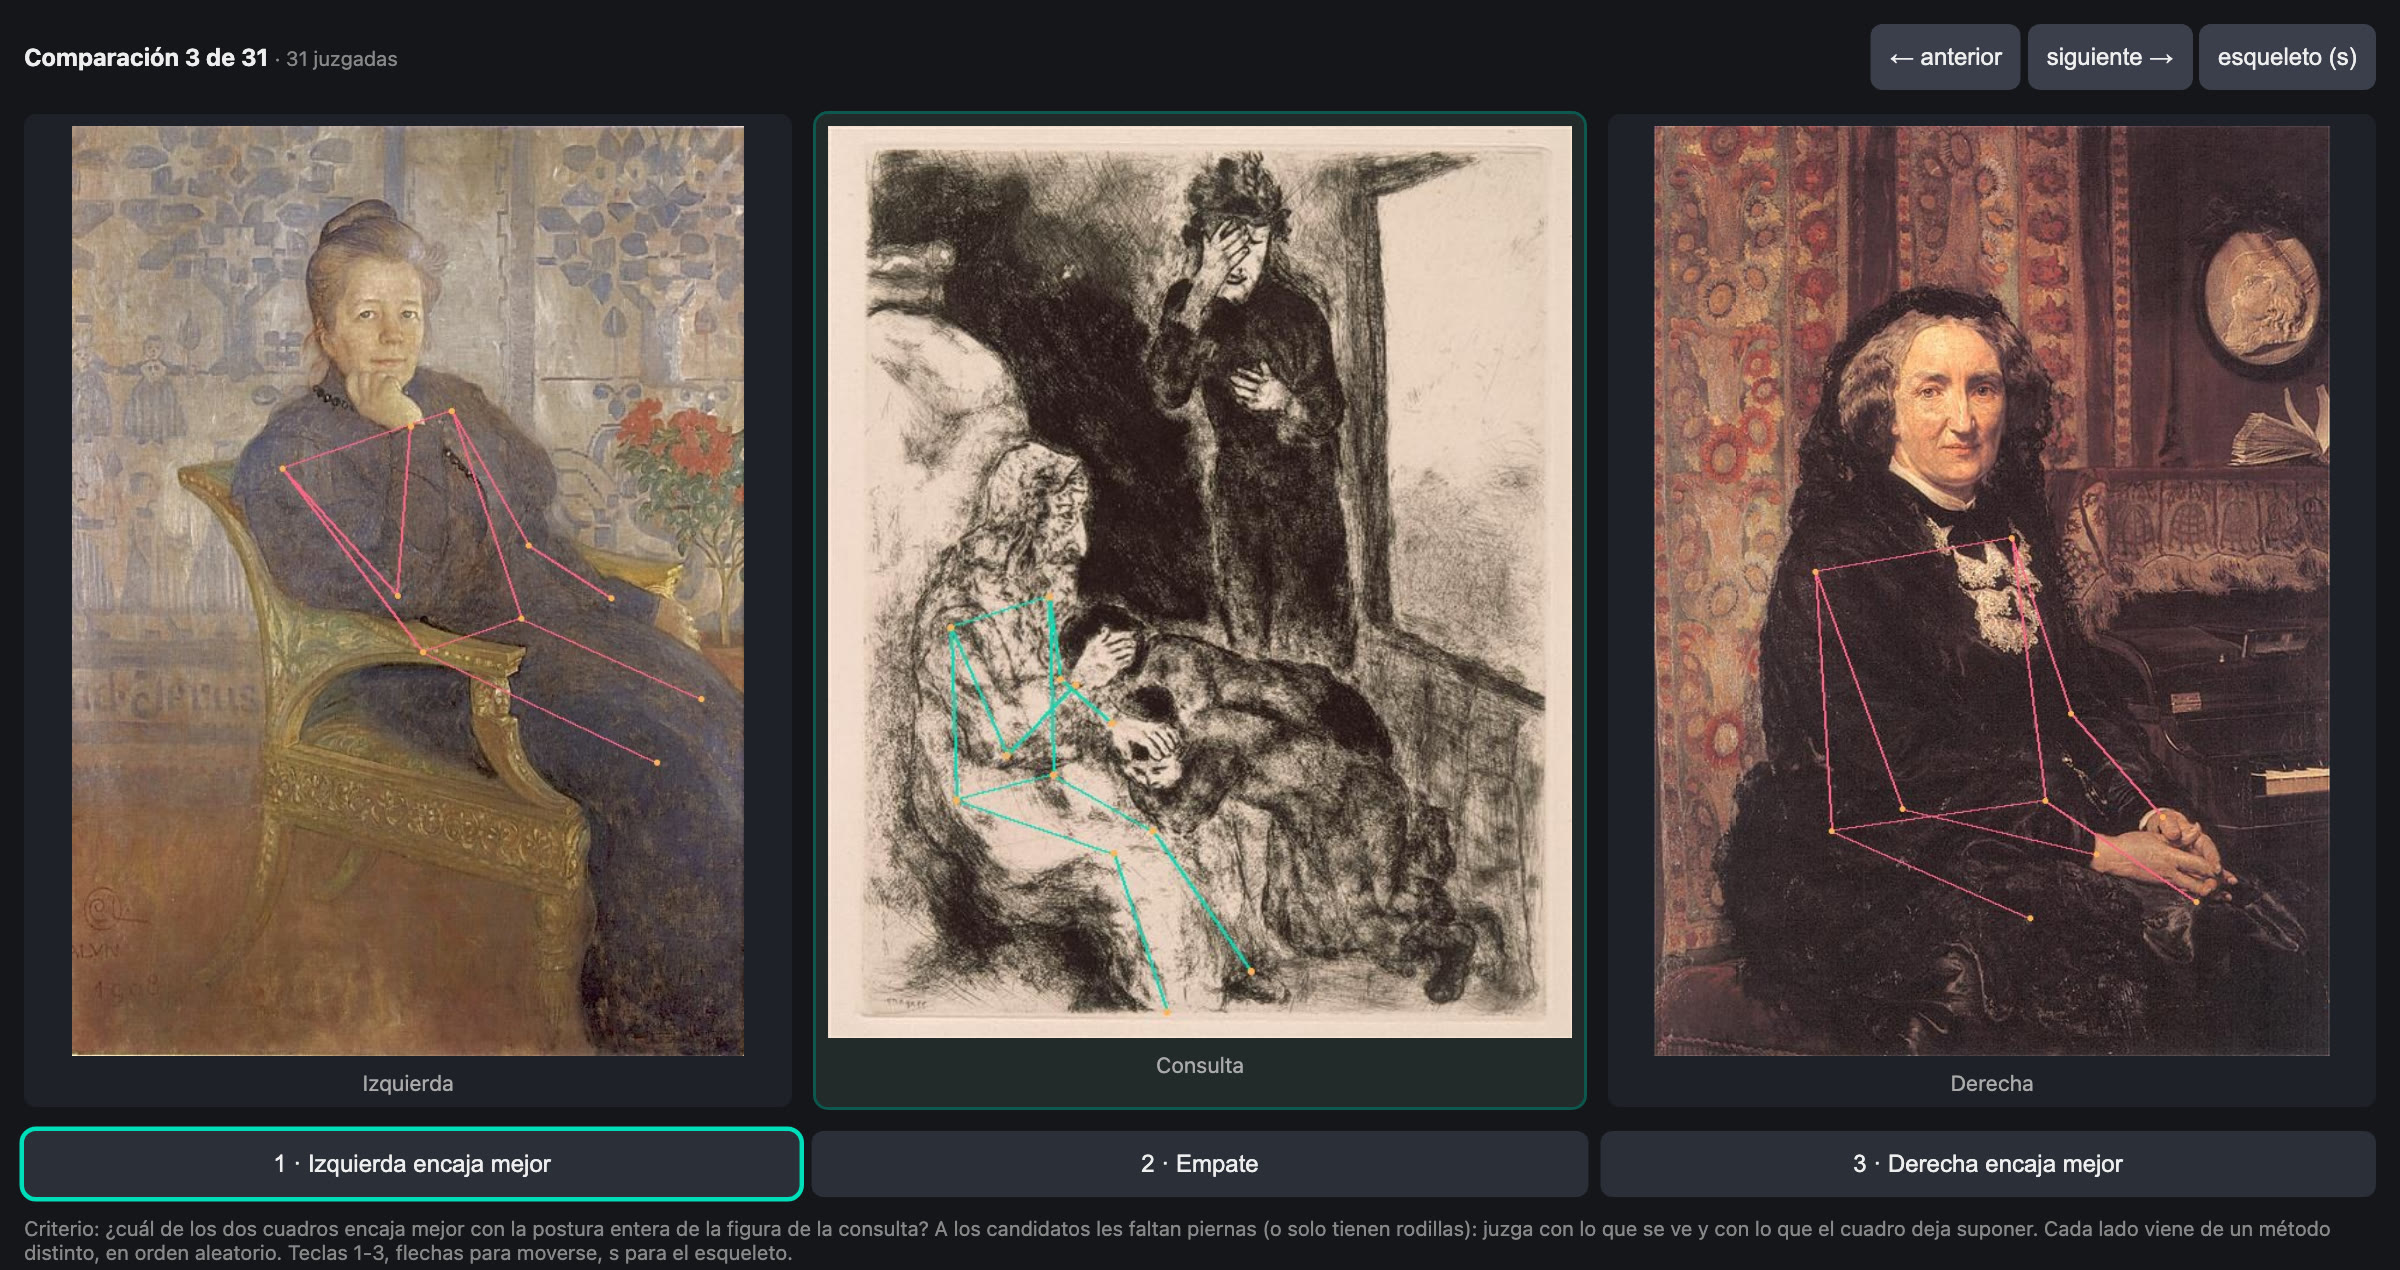
La herramienta de la segunda revisión. En el centro, una figura con sus piernas reales. A los lados, dos cuadros a los que les faltan, cada uno elegido por un método distinto y colocados al azar. Yo marcaba cuál encajaba mejor sin saber de dónde venía cada uno.
En la Partitura
La red trabaja una sola vez, al construir el índice: propone piernas a las 648 figuras que no las tienen, y cuanto más duda de una pierna, menos pesa esa pierna al buscar parecidos. En pantalla se dibujan a trazos, como lo que son, una suposición. A veces se salen del marco y dibujan debajo del lienzo unas piernas que el pintor nunca pintó, que es la imagen del principio. Algo que no existe, pero que sale de transformar lo que hay y no de generarlo de cero.
Por qué esta red neuronal
Me bastaba un modelo que supiera hacer una sola cosa, en un sitio concreto, con datos que puedo nombrar uno a uno, y que se pudiera medir contra la alternativa tonta. La geometría hace el trabajo grande, y la red rellena el hueco que la geometría no puede medir. Sin red, la Partitura seguiría funcionando, solo que con 648 figuras cojas. La red me ha permitido además explorar otra forma de trabajar con IA, creando un modelo propio.
La idea de trabajar así la saqué de Desert Ant Labs, que hace modelos diminutos para problemas concretos. Su Shapes, por ejemplo, reconoce si un trazo hecho a mano es un rectángulo, una elipse o una estrella con un modelo de 0,2 MB que va dentro de la propia aplicación, sin llamar a nadie.
Esta es otra manera de acercarse al aprendizaje automático, distinta de la que se vende ahora, donde todo problema parece pedir un modelo enorme al que se le pregunta, tan inmenso que no sabemos qué ha visto ni cómo mira. Una pieza de 300 KB se entiende entera: sé con qué cuerpos aprendió, qué le tapé, cuándo duda y cuánto gana a no usarla. Y nada impide que uno de esos grandes modelos la use como herramienta.
Está claro que la dirección general es otra, y que los grandes modelos harán converger cada vez más elementos digitales en su representación interna, como propone el artículo de la piedra de Rosetta. Pero en eso nosotros solo seremos usuarios y gastaremos sus tokens. Aquí todavía podemos hacer un poco de alquimia.