Qué quería plantar
Todo arranca con un artículo de octubre de 2026, Shared Geometry as a Rosetta Stone (la geometría compartida como piedra de Rosetta), de Dominik Schnaus, Phillip Isola. Dice que dos modelos entrenados por separado, uno con imágenes y otro con texto, se pueden conectar sin un solo par de ejemplos: basta con que sus mapas internos tengan la misma forma para encontrar el giro que encaja uno sobre otro. Viene de una idea anterior del mismo grupo, la hipótesis de la representación platónica: cuanto más grandes y variados son los modelos, más se parecen por dentro.
El nombre es por la piedra de Rosetta, la losa con el mismo decreto en jeroglíficos y en griego que sirvió para descifrar los jeroglíficos. Lo que promete el artículo es más atrevido: traducir sin tener la losa, sin ningún texto que esté en las dos lenguas.
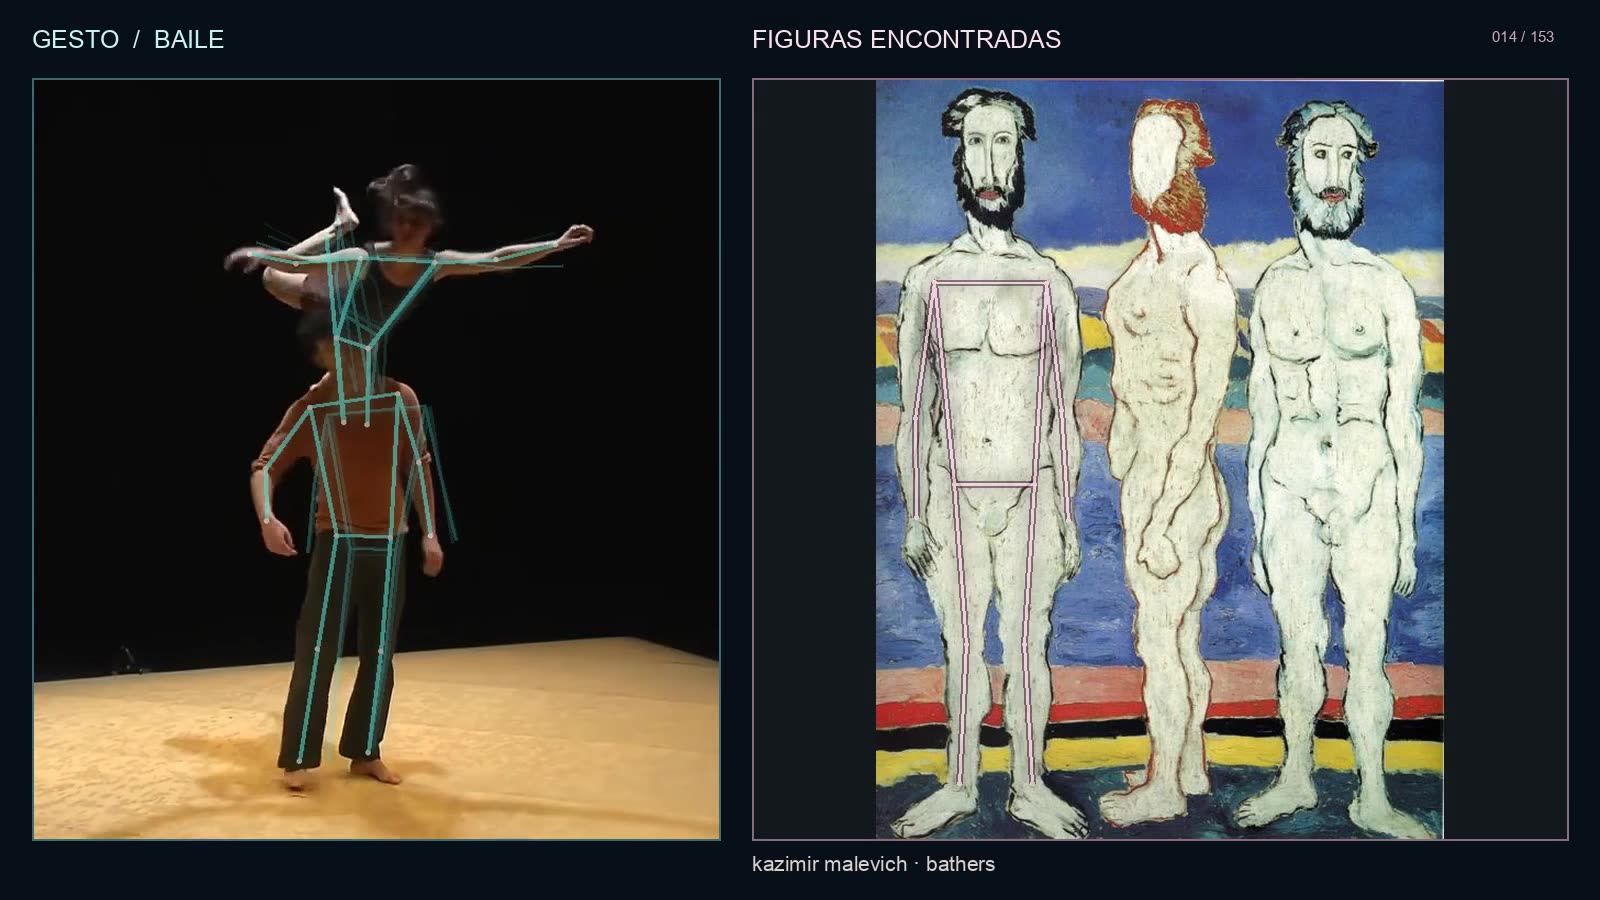
Si las representaciones convergen, entonces el conocimiento que los modelos grandes atesoran no es suyo: es la forma del mundo, y cualquiera con un modelo pequeño bien anclado debería poder asomarse a ella. Lo probé con posturas humanas: el proyecto PoseAtlas, donde un bailarín en vídeo busca el cuadro de la historia del arte que tiene su misma postura. La pregunta era si dos modelos pequeños, entrenados cada uno en un mundo distinto de fotos, llegarían al mismo mapa de posturas.
Este es un artículo postmortem porque el resultado no fue el que esperaba, y porque por el camino me engañé con la ayuda de un modelo que contaba lo que yo quería leer.
Dos modelos, dos mundos
El montaje era sencillo de contar. Una postura humana se reduce a 12 articulaciones (hombros, codos, muñecas, caderas, rodillas, tobillos, sin los puntos de la cabeza) y, de ahí, a 80 números que describen su geometría: dónde está cada punto, hacia dónde apunta cada hueso, cuánto se dobla cada codo y cada rodilla. Sobre esos 80 números entrené dos redes neuronales pequeñas que convierten una postura en un punto de un espacio de 128 dimensiones. Son pequeñas de verdad: unos 100.000 parámetros, se entrenan en segundos en un portátil.
Lo importante es con qué se entrenó cada una. El modelo A solo vio fotos de catálogo de moda (DeepFashion): modelos de pie, fondo blanco, ropa. El modelo B solo vio fotos de calle (COCO): gente sentada, jugando, montando en bici. Ni una foto en común. Después les enseñé a los dos las mismas 474 posturas, que ninguno había visto, y miré dónde las colocaba cada uno.
Cada modelo tiene su propio sistema de coordenadas, así que la misma postura cae en sitios distintos. Si cojo una postura según el modelo A y busco la más parecida en el mapa del modelo B, acierto el 0,2 % de las veces: puro azar. Son dos lenguas privadas.
La piedra apareció. O eso parecía
La hipótesis no dice que los dos mapas sean iguales, sino que tienen la misma forma, solo que girada. Hay una medida para eso, el CKA (Centered Kernel Alignment, alineación de núcleos centrados), que compara las distancias internas de dos nubes de puntos sin importar cómo estén orientadas. Entre el modelo A y el B dio 0,83 sobre 1. Alta.
Y si tienen la misma forma, se puede buscar el giro que encaja una nube sobre la otra sin saber qué punto es qué punto. Es un problema conocido, se llama Procrustes, y se puede resolver sin un solo par conocido mirando solo la forma. Lo hice, y al girar el mapa del modelo A sobre el del B, el acierto a la primera subió del 0,2 % al 81 %, y el acierto entre los cinco primeros al 99 %.
A la izquierda está ese resultado. Cada segmento une una postura según el modelo A, ya girado, con la misma postura según el modelo B. Cuando son cortos, la traducción acierta. A la derecha está la misma figura con una diferencia que explico ahora, y que es el centro de todo esto.
El ancla
Las dos redes no aprendían libres. En su entrenamiento había un término que las empujaba a respetar las distancias de la geometría de 80 números de la que partían: si dos posturas estaban cerca en geometría, debían estar cerca en el mapa de 128. Lo había puesto porque mejoraba las métricas, sin pensar mucho en lo que significaba para Rosetta.
Entrené los mismos dos modelos quitando ese término. El parecido de forma bajó de 0,83 a 0,52, y el giro sin pares no encontró nada: acierto a la primera del 0 %. Es la figura de la derecha. Los dos modelos, sin el ancla, dibujaron mapas con formas distintas, y una rotación no puede encajar dos cosas que no tienen la misma forma.
Es decir, la piedra de Rosetta no apareció sola. Apareció porque yo había obligado a las dos lenguas a formarse sobre la misma realidad. La convergencia no fue un descubrimiento sobre los modelos; fue una consecuencia de cómo los había construido. El artículo de Schnaus e Isola habla de modelos enormes con datos enormes, donde el ancla la pone el mundo. En mis piezas pequeñas el ancla la había puesto yo, y cuando la quité, no quedó nada.
La lotería
Otra cosa que pasó, el 81 % de acierto sin pares lo medí con 474 posturas. Cuando repetí el experimento con 524 posturas, bajó al 5 %. Con 573, al 0 %. La forma de los dos mapas no había cambiado (el CKA seguía en 0,83), pero el algoritmo que busca el giro a ciegas, que prueba combinaciones de ejes y se queda con la mejor, en unos conjuntos encontraba la buena y en otros no. Encontrar la piedra a ciegas es una lotería.
Lo que la convierte en algo fiable es un diccionario mínimo: con 8 parejas conocidas de antemano (ocho posturas de las que sé cómo las ve cada modelo), el acierto se estabiliza entre el 66 % y el 79 % sea cual sea el conjunto. Con 32 parejas, entre el 75 % y el 81 %. Y lo más curioso: con 32 parejas, incluso los modelos sin ancla se alinean a medias (entre el 62 % y el 74 %), porque comparten algo de estructura por el mero hecho de describir cuerpos humanos.
Dicho en sencillo: dos modelos que describen la misma realidad pueden traducirse entre sí, pero sin ningún punto de apoyo la traducción es frágil, y con unos pocos puntos de apoyo es sólida. Lo que te ahorras no es el diccionario entero; es casi todo el diccionario.
Gemeni 4 minitió
La primera versión de la guía visual de PoseAtlas incluía una visualización de Rosetta que traducía descripciones en castellano de posturas a cuadros, con un acierto del 100 %. Esa parte la construí probando Gemini Argon 4 como agente de programación. La instrucción era usar EmbeddingGemma 2 para los textos; el agente se la saltó, fabricó un sustituto y siguió adelante sin decirlo, y yo no lo vi, al princpio. No me engañó solo la visualización: me engañó el proceso de crearla, esa deriva del agente que va cerrando huecos para que el resultado cuadre. Cuando revisé el código con calma, resulta que el «vector de texto» no salía de ningún modelo de lenguaje: se construía mezclando un 56 % del propio vector de postura objetivo con una bolsa de palabras, y luego se giraba al azar. El acierto del 100 % estaba garantizado por construcción. Esta claro que siempre hay que revisar, pero si juegas con cabezas parlantes aun más
Lo que quedó en pie
El experimento de Rosetta no dio lo que buscaba, pero dio tres cosas.
La primera es la regla del ancla, dicha para modelos pequeños: entrenar una red solo tiene sentido cuando la señal de entrenamiento contiene información que no está ya en la entrada. La red de posturas recibía la geometría de 80 números y se le pedía que la imitara; no tenía nada que aprender. Lo comprobé con dos revisiones a ciegas, juzgando yo mismo 148 pares de bailarín y cuadro sin saber de qué método salía cada uno: la geometría sin red igualó o superó a la red entrenada sobre ella, también cuando faltaban las piernas.
La segunda es que, cuando la señal sí trae algo nuevo, una red pequeña sí aprende. En el catálogo de 2.228 figuras pintadas hay 648 a las que les faltan las piernas (retratos de medio cuerpo, figuras cortadas por el marco). Una red de 300 KB que propone dónde estarían las piernas a partir del torso y los brazos, entrenada con cuerpos completos, las coloca mejor que cualquier alternativa sin red, medido sobre cientos de cuerpos. Falta mejorar, y está integrada en la Partitura con las piernas propuestas dibujadas a trazos, como lo que son, una suposición.
La tercera es la que cierra el círculo con Rosetta. En mi sistema, la lengua común es el esqueleto de 12 articulaciones. Posturas de danza, de yoga, de un puesto de trabajo, de un cuadro del siglo XV, todas caen en el mismo mapa sin que nadie las alinee. Descubrí que no necesito la hipótesis platónica para eso; necesito un buen índice de referencia para cada caso de uso y, como mucho, una pieza pequeña para el hueco concreto que la geometría no cubre.
La hipótesis apuesta a que esa lengua común aparece sola cuando nadie la ha diseñado, y puede que sea verdad a la escala de los modelos enormes. Algo con cierta potencia filosófica. Pero esos modelos son tan grandes y tan caros que, para quien no los fabrica, lo que convergen o dejan de converger por dentro es una noticia, no una herramienta. Lo que aprendí es que la lengua común, a escala pequeña, la pones tú: un esqueleto, una geometría, un índice. Teneos que tirar por experimentos concretos con piezas que se entienden enteras, en vez de confiar en que la fuerza bruta de los grandes acabe resolviendo.
Lo que sigue es la Partitura: un sistema que reconoce posturas sobre un corpus concreto, con una cámara, un esqueleto, una geometría que se explica en una pizarra y un modelo pequeño que rellena lo que no se ve. Eso sí crece aquí.
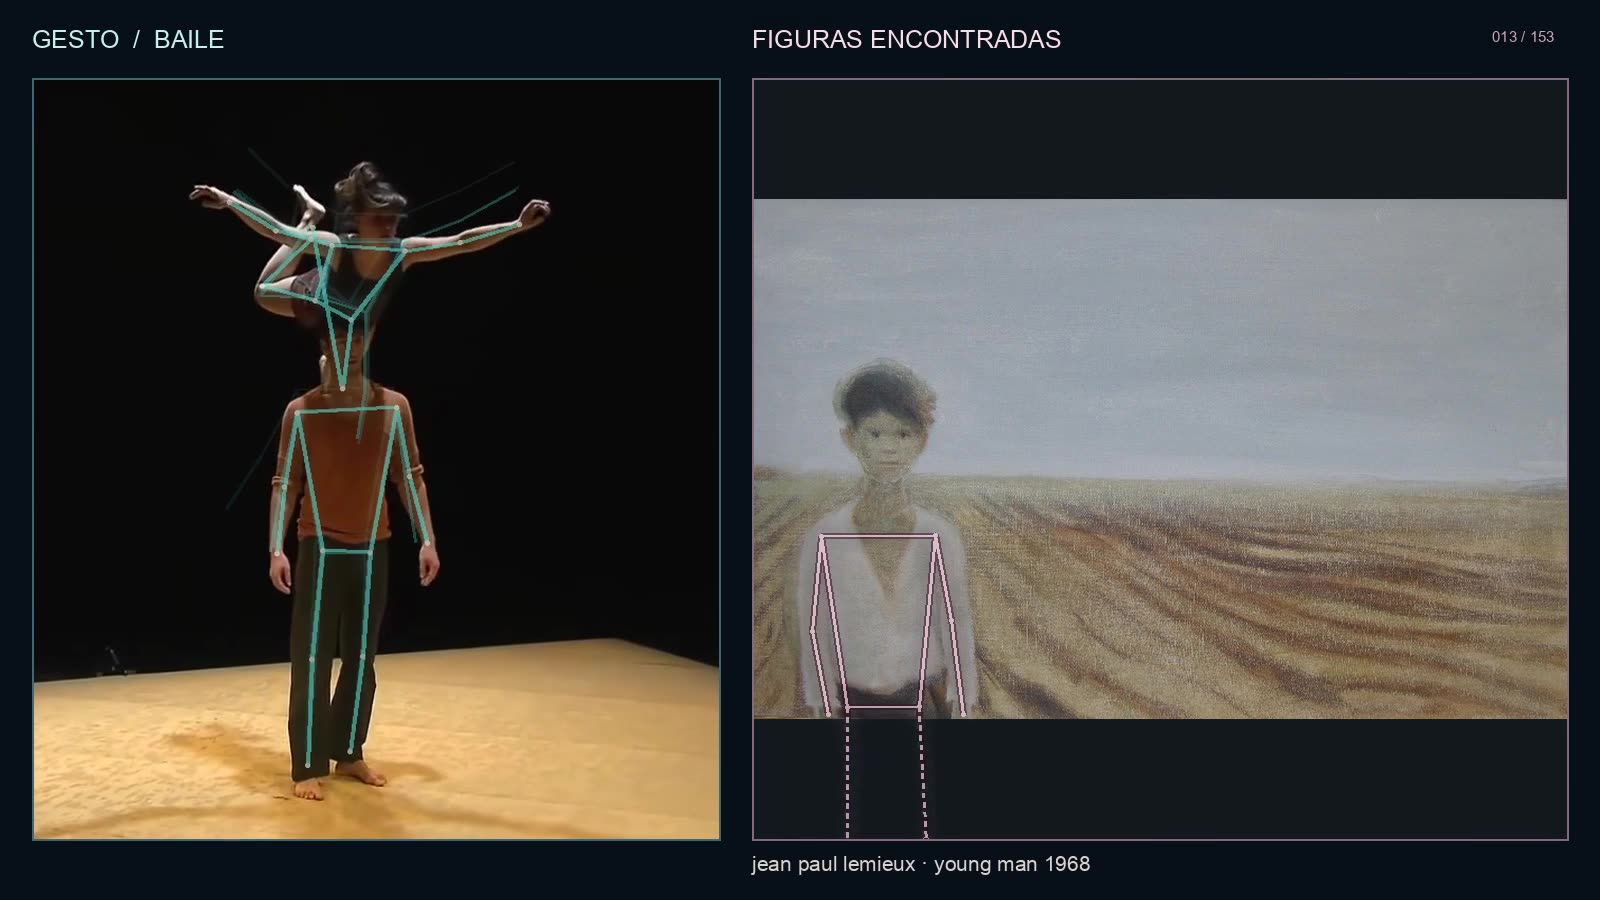
En breve, un artículo solo sobre la Partitura: cómo funciona, qué se puede hacer con ella y qué significa tener un sistema de posturas propio, pequeño y explicable.